Domain waor.de kaufen?
Wir ziehen mit dem Projekt
waor.de um.
Sind Sie am Kauf der Domain
waor.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain waor.de kaufen?
Gibt es Suchmaschinen, deren Webcrawler die robots.txt ignorieren?
Ja, es gibt Suchmaschinen, deren Webcrawler die robots.txt ignorieren. Ein Beispiel dafür ist beispielsweise die Suchmaschine "Yandex". Dies kann dazu führen, dass Inhalte, die in der robots.txt-Datei als nicht zugänglich markiert sind, dennoch von diesen Suchmaschinen indexiert werden. **
Was ist ein Webcrawler und wie funktioniert er?
Ein Webcrawler ist ein Computerprogramm, das automatisch das Internet durchsucht, um Informationen zu sammeln. Er funktioniert, indem er eine Liste von URLs abruft, die er dann besucht und den Inhalt indexiert. Der Webcrawler folgt dabei Links auf den besuchten Seiten, um weitere Informationen zu sammeln. **


Ähnliche Suchbegriffe für Webcrawler
Top-Angebote
Produkte zum Begriff Webcrawler:
-
Ortstafeln mit militärischen Bezeichnungen im Deutschland des 19. und frühen 20. Jahrhunderts Das Ergebnis einer Recherche, Taschenbuch von HartmutOrtstafeln Mit Militärischen Bezeichnungen Im Deutschland Des 19. Und Frühen 20. Jahrhunderts Das Ergebnis Einer Recherche, Taschenbuch Von Hartmut Gräber, Bod – Books On Demand, 978-3-7526-9009-5, Seitenanzahl: 14411,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Im Zugriff von Fürsorge und PolizeiIm Zugriff von Fürsorge und Polizei , Erfahrungen sozialrassistischer Verfolgung im Nationalsozialismus , Rückschlagventile > Kraftstoffversorgung , Erscheinungsjahr: 20240814, Produktform: Kartoniert, Titel der Reihe: Beiträge zur Geschichte der nationalsozialistischen Verfolgung#5#, Redaktion: Gaida, Oliver~¿I¿I¿, Alyn, Seitenzahl/Blattzahl: 229, Themenüberschrift: HISTORY / Modern / 20th Century, Keyword: Arbeit; Arbeitshaus; Asozial; Augsburg; Berlin; Berufsverbrecher; Entschädigung; Erziehung; Erziehungsheim; Farmsen; Frauen; Fürsorge; Glückstadt; Heime; Jugend; Jugendschutzlager; Konzentrationslager; Kriminalpolizei; Nationalsozialismus; Niederlande; Rassismus; Restriktionen; Stutthoff; Zwangsfürsorge, Fachschema: Faschismus / Nationalsozialismus~Nationalsozialismus~Nazifizierung~Nazismus~Archiv~Diskriminierung~Judentum~Weltreligionen / Judentum~Judentum / Erinnerung, Brief, Tagebuch~Christentum~Weltreligionen / Christentum~Virtualisierung, Fachkategorie: Tatsachenberichte: Leben nach Missbrauch, erlittenem Unrecht, Justizirrtum, Traumata~Archivierung, Konservierung und Digitalisierung~Soziale Diskriminierung und soziale Gleichbehandlung~Judentum~Christentum~Virtualisierung~Geschichte allgemein und Weltgeschichte, Warengruppe: TB/Geschichte/20. Jahrhundert, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Länge: 240, Breite: 168, Höhe: 15, Gewicht: 446, Produktform: Kartoniert, Genre: Geisteswissenschaften/Kunst/Musik,22,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
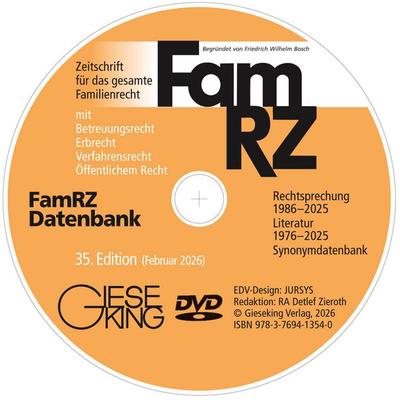
FamRZ DatenbankDie Famrz Datenbank Ist Die Authentische Datenbank Zur Famrz, Der Zeitschrift Für Das Gesamte Familienrecht Mit Betreuungsrecht, Erbrecht, Verfahrensrecht, Öffentlichem Recht - Also Das Original Auf Dvd. Ihre Vorteile Auf Einen Blick:nn- Volltext...279,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter


-
Wie können Webcrawler dazu beitragen, Informationen im Internet effizient zu sammeln und zu katalogisieren?
Webcrawler sind automatisierte Programme, die das Internet nach Inhalten durchsuchen und diese indexieren. Sie können dabei helfen, Informationen aus verschiedenen Quellen zu sammeln und zu strukturieren. Durch die Verwendung von Webcrawlern können Suchmaschinen wie Google relevante Informationen schneller und effizienter bereitstellen. **
-
Wie funktionieren Webcrawler und welche Rolle spielen sie bei der Indizierung von Inhalten im Internet?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Webseiten folgen und deren Inhalte indexieren. Sie verwenden Algorithmen, um relevante Informationen zu sammeln und zu speichern, um sie später in Suchmaschinen abrufbar zu machen. Die gesammelten Daten werden dann in einer Datenbank gespeichert und von Suchmaschinen verwendet, um relevante Suchergebnisse für Benutzer bereitzustellen. Webcrawler spielen somit eine entscheidende Rolle bei der Indizierung von Inhalten im Internet, da sie die Grundlage für die Auffindbarkeit von Informationen in Suchmaschinen bilden. **
-
Wie funktionieren Webcrawler und welche Rolle spielen sie bei der Indexierung von Inhalten im Internet?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Webseiten folgen. Sie sammeln Informationen über Webseiten und speichern sie in einer Datenbank. Diese gesammelten Informationen werden dann von Suchmaschinen verwendet, um Webseiten zu indexieren und in den Suchergebnissen anzuzeigen. Webcrawler spielen also eine wichtige Rolle bei der Indexierung von Inhalten im Internet, indem sie Suchmaschinen dabei helfen, relevante Informationen zu finden und zu organisieren. **
-
Wie können Webcrawler verwendet werden, um Daten aus dem Internet zu sammeln und zu analysieren?
Webcrawler sind automatisierte Programme, die das Internet nach bestimmten Informationen durchsuchen. Sie können verwendet werden, um Daten wie Texte, Bilder oder Links von Websites zu sammeln. Die gesammelten Daten können dann analysiert werden, um Trends, Muster oder Informationen zu extrahieren. **


Wie funktionieren Webcrawler und wie werden sie zur Indexierung von Websites eingesetzt?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Websites folgen. Sie sammeln Informationen über Websites und speichern sie in einer Datenbank. Diese gesammelten Informationen werden dann von Suchmaschinen verwendet, um die Websites zu indexieren und in den Suchergebnissen anzuzeigen. **
Wie funktionieren Webcrawler und welche Rolle spielen sie beim Indizieren von Websites?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Websites folgen und deren Inhalte indexieren. Sie scannen Websites nach relevanten Keywords und Meta-Tags, um sie in Suchmaschinen-Datenbanken zu speichern. Dadurch ermöglichen sie Suchmaschinen, relevante Websites für bestimmte Suchanfragen zu finden und anzuzeigen. **
Top-Angebote
Produkte zum Begriff Webcrawler:
-
Die Online-Inhaltsanalyse. Forschungsobjekt Internet, FachbücherViele etablierte Massenmedien bauen derzeit ihre Online-Präsenzen aus. Zusätzlich wandern klassische Inhalte zusehends ins Internet. Das wirft methodische Fragen auf, wie künftig diese Inhalte analysiert werden sollen. Die Inhaltsanalyse ist eine zentrale Schlüsselmethode der Sozialwissenschaften. In Form der Online-Inhaltsanalyse fristet sie allerdings ein Schattendasein. Der Band arbeitet deshalb zahlreiche methodische Problemfelder von Online-Inhaltsanalysen auf. Praktische Fallbeispiele ergänzen mit dem How-to die theoretischen Überlegungen.28,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Moderne Enzyklopädisten: Wie die kostenlose Internet-Datenbank Wikipedia entsteht - Karl-Heinz Wellmann, Audio, 4056198013199Moderne Enzyklopädisten: Wie Die Kostenlose Internet-datenbank Wikipedia Entsteht Von Karl-heinz Wellmann, Hessischer Rundfunk, Sprecher: Karl-heinz Wellmann, Sprache: Deutsch0,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Ortstafeln mit militärischen Bezeichnungen im Deutschland des 19. und frühen 20. Jahrhunderts Das Ergebnis einer Recherche, Taschenbuch von HartmutOrtstafeln Mit Militärischen Bezeichnungen Im Deutschland Des 19. Und Frühen 20. Jahrhunderts Das Ergebnis Einer Recherche, Taschenbuch Von Hartmut Gräber, Bod – Books On Demand, 978-3-7526-9009-5, Seitenanzahl: 14411,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Im Zugriff von Fürsorge und PolizeiIm Zugriff von Fürsorge und Polizei , Erfahrungen sozialrassistischer Verfolgung im Nationalsozialismus , Rückschlagventile > Kraftstoffversorgung , Erscheinungsjahr: 20240814, Produktform: Kartoniert, Titel der Reihe: Beiträge zur Geschichte der nationalsozialistischen Verfolgung#5#, Redaktion: Gaida, Oliver~¿I¿I¿, Alyn, Seitenzahl/Blattzahl: 229, Themenüberschrift: HISTORY / Modern / 20th Century, Keyword: Arbeit; Arbeitshaus; Asozial; Augsburg; Berlin; Berufsverbrecher; Entschädigung; Erziehung; Erziehungsheim; Farmsen; Frauen; Fürsorge; Glückstadt; Heime; Jugend; Jugendschutzlager; Konzentrationslager; Kriminalpolizei; Nationalsozialismus; Niederlande; Rassismus; Restriktionen; Stutthoff; Zwangsfürsorge, Fachschema: Faschismus / Nationalsozialismus~Nationalsozialismus~Nazifizierung~Nazismus~Archiv~Diskriminierung~Judentum~Weltreligionen / Judentum~Judentum / Erinnerung, Brief, Tagebuch~Christentum~Weltreligionen / Christentum~Virtualisierung, Fachkategorie: Tatsachenberichte: Leben nach Missbrauch, erlittenem Unrecht, Justizirrtum, Traumata~Archivierung, Konservierung und Digitalisierung~Soziale Diskriminierung und soziale Gleichbehandlung~Judentum~Christentum~Virtualisierung~Geschichte allgemein und Weltgeschichte, Warengruppe: TB/Geschichte/20. Jahrhundert, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Länge: 240, Breite: 168, Höhe: 15, Gewicht: 446, Produktform: Kartoniert, Genre: Geisteswissenschaften/Kunst/Musik,22,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Gibt es Suchmaschinen, deren Webcrawler die robots.txt ignorieren?
Ja, es gibt Suchmaschinen, deren Webcrawler die robots.txt ignorieren. Ein Beispiel dafür ist beispielsweise die Suchmaschine "Yandex". Dies kann dazu führen, dass Inhalte, die in der robots.txt-Datei als nicht zugänglich markiert sind, dennoch von diesen Suchmaschinen indexiert werden. **
-
Was ist ein Webcrawler und wie funktioniert er?
Ein Webcrawler ist ein Computerprogramm, das automatisch das Internet durchsucht, um Informationen zu sammeln. Er funktioniert, indem er eine Liste von URLs abruft, die er dann besucht und den Inhalt indexiert. Der Webcrawler folgt dabei Links auf den besuchten Seiten, um weitere Informationen zu sammeln. **
-
Wie können Webcrawler dazu beitragen, Informationen im Internet effizient zu sammeln und zu katalogisieren?
Webcrawler sind automatisierte Programme, die das Internet nach Inhalten durchsuchen und diese indexieren. Sie können dabei helfen, Informationen aus verschiedenen Quellen zu sammeln und zu strukturieren. Durch die Verwendung von Webcrawlern können Suchmaschinen wie Google relevante Informationen schneller und effizienter bereitstellen. **
-
Wie funktionieren Webcrawler und welche Rolle spielen sie bei der Indizierung von Inhalten im Internet?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Webseiten folgen und deren Inhalte indexieren. Sie verwenden Algorithmen, um relevante Informationen zu sammeln und zu speichern, um sie später in Suchmaschinen abrufbar zu machen. Die gesammelten Daten werden dann in einer Datenbank gespeichert und von Suchmaschinen verwendet, um relevante Suchergebnisse für Benutzer bereitzustellen. Webcrawler spielen somit eine entscheidende Rolle bei der Indizierung von Inhalten im Internet, da sie die Grundlage für die Auffindbarkeit von Informationen in Suchmaschinen bilden. **
Ähnliche Suchbegriffe für Webcrawler
-
FamRZ DatenbankDie Famrz Datenbank Ist Die Authentische Datenbank Zur Famrz, Der Zeitschrift Für Das Gesamte Familienrecht Mit Betreuungsrecht, Erbrecht, Verfahrensrecht, Öffentlichem Recht - Also Das Original Auf Dvd. Ihre Vorteile Auf Einen Blick:nn- Volltext...279,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wie funktionieren Webcrawler und welche Rolle spielen sie bei der Indexierung von Inhalten im Internet?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Webseiten folgen. Sie sammeln Informationen über Webseiten und speichern sie in einer Datenbank. Diese gesammelten Informationen werden dann von Suchmaschinen verwendet, um Webseiten zu indexieren und in den Suchergebnissen anzuzeigen. Webcrawler spielen also eine wichtige Rolle bei der Indexierung von Inhalten im Internet, indem sie Suchmaschinen dabei helfen, relevante Informationen zu finden und zu organisieren. **
-
Wie können Webcrawler verwendet werden, um Daten aus dem Internet zu sammeln und zu analysieren?
Webcrawler sind automatisierte Programme, die das Internet nach bestimmten Informationen durchsuchen. Sie können verwendet werden, um Daten wie Texte, Bilder oder Links von Websites zu sammeln. Die gesammelten Daten können dann analysiert werden, um Trends, Muster oder Informationen zu extrahieren. **
-
Wie funktionieren Webcrawler und wie werden sie zur Indexierung von Websites eingesetzt?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Websites folgen. Sie sammeln Informationen über Websites und speichern sie in einer Datenbank. Diese gesammelten Informationen werden dann von Suchmaschinen verwendet, um die Websites zu indexieren und in den Suchergebnissen anzuzeigen. **
-
Wie funktionieren Webcrawler und welche Rolle spielen sie beim Indizieren von Websites?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Websites folgen und deren Inhalte indexieren. Sie scannen Websites nach relevanten Keywords und Meta-Tags, um sie in Suchmaschinen-Datenbanken zu speichern. Dadurch ermöglichen sie Suchmaschinen, relevante Websites für bestimmte Suchanfragen zu finden und anzuzeigen. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.